Zero-Day Ready
紧跟快速演进的模型生态,通过我们的推理性能优化社区,第一时间完成新模型适配和调优,让最新大模型能够快速导入、配置并部署到生产环境。
即日认证模型库100% 官方适配通过
DeepSeek-V4-ProDeepSeek-V4-Flash-0731Qwen3.8-2.4T-A95BKimi-K3MiniMax-M3GLM-5.3-Flash
让大模型推理从“能跑”到“生产好用”,让每张 GPU 化身高效 Token 产线。
基于 Kubernetes 构建,将模型部署、缓存感知路由、按 SLO 弹性伸缩、全维可观测性、挂起故障秒级自愈与 Tuning Agent 闭环组织成一套工业级推理调度系统,帮助开发者在复杂异构算力上稳定承载大规模生产流量。
 Claude
 Codex
 OpenClaw
标准 API 接入
生产级算力部署与推理优化开源平台
统一部署与服务治理
异构资源纳管与调度
Architectural Pillars
为生产级严肃工程而生。模域将前沿学术成果与大规模线上运维沉淀收敛为标准化的平台体系。
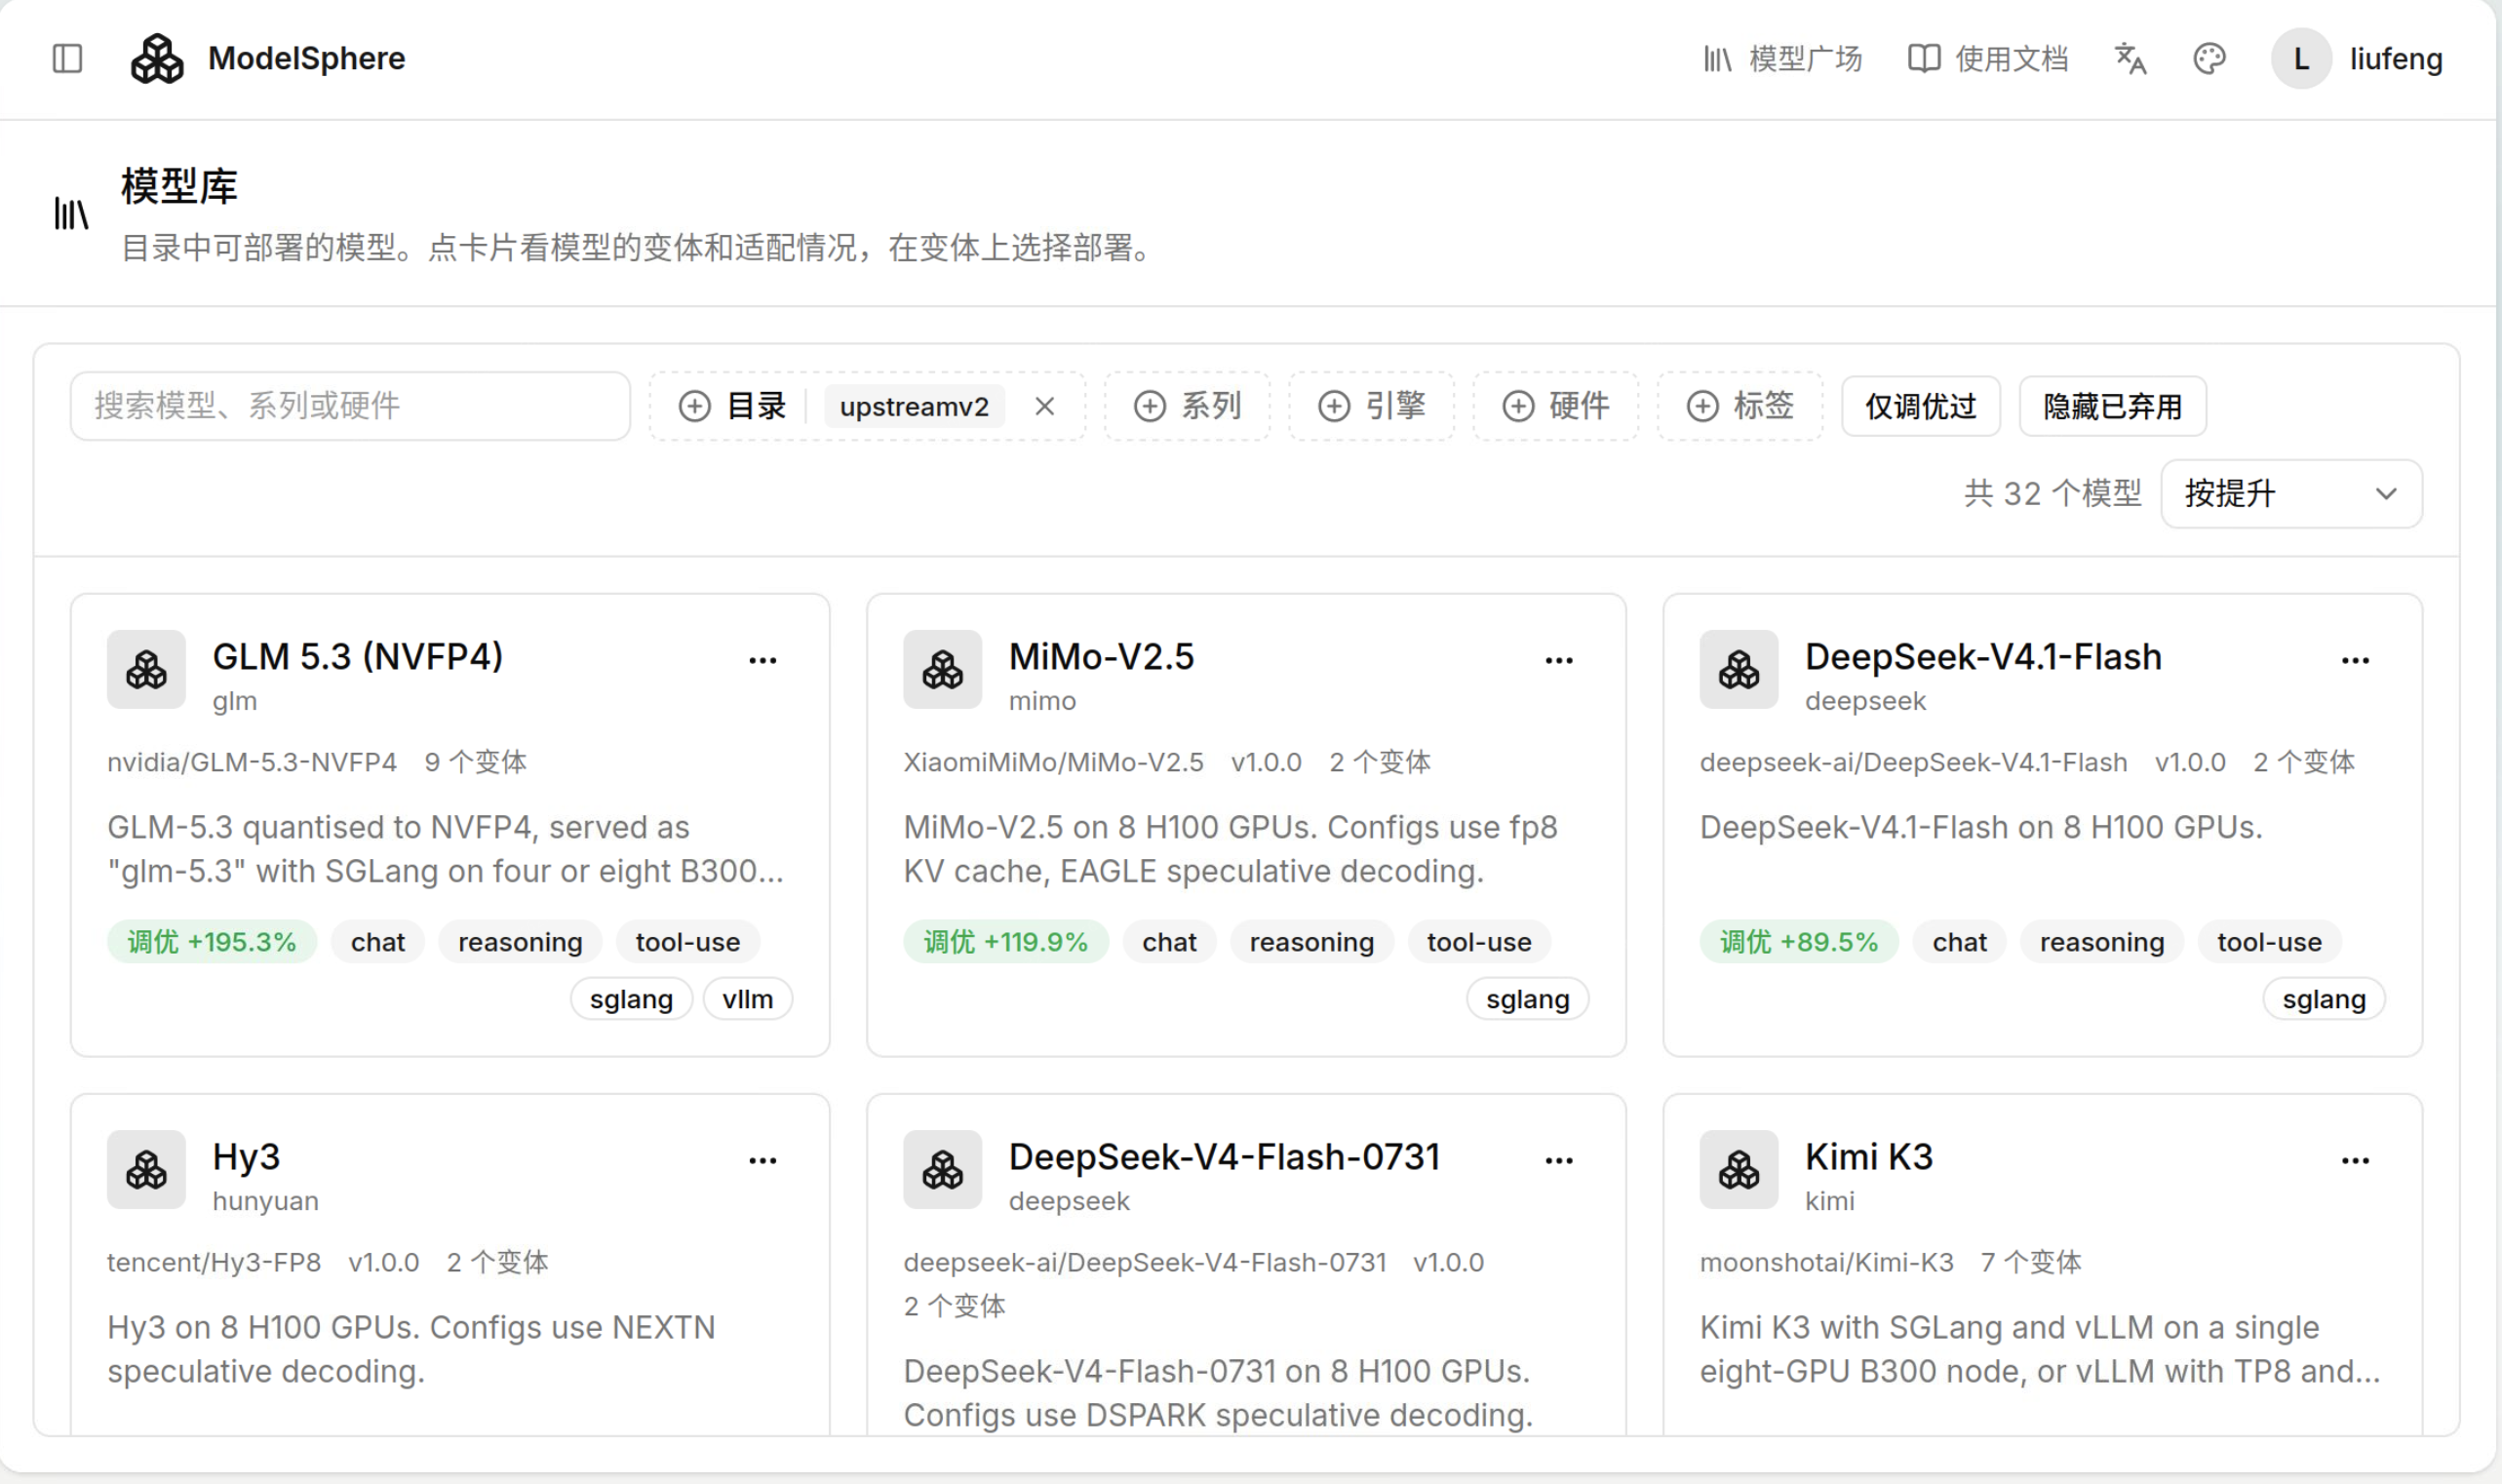
紧跟快速演进的模型生态,通过我们的推理性能优化社区,第一时间完成新模型适配和调优,让最新大模型能够快速导入、配置并部署到生产环境。
几分钟内即可搭建面向生产环境的AI推理平台,开箱即具备模型服务、调度、弹性伸缩、可观测性和运维等核心能力。提供直观的统一WebUI面板,无需复杂的底层调优即可轻松接管集群。
通过统一的平台无缝运行在多种异构AI硬件之上。原生兼容通用GPU,并深度基于EngineX适配华为昇腾、天数智芯、摩尔线程、海光等加速芯片,实现混合节点的统一纳管。
持续集成最新的推理优化能力,通过内置 Tuning Agent 根据模型、硬件和真实业务负载自动调优,在延迟、吞吐和资源效率之间持续获得更优表现。
在模型广场中选择模型与部署变体,使用已调优配置一键部署。
利用整个算力集群的整体资源,保障每一位用户的模型服务质量。无需重新提问,绝无报错中断。
心跳毫秒探测,主动拦截单卡雪崩
拓扑健康调度,秒级迁往空闲节点
历史缓存同步热迁,语义连贯无割裂
请详细分析一下2025年企业级大模型算力集群的核心建设原则与最佳实践?
大模型集群建设的首要原则是【高吞吐与容灾韧性】。在实际生产高并发场景下,单节点显存波动、网卡瞬断或硬件死机在所难免。
因此系统必须具备智能上下文热迁移能力,无需客户端重试,自动分配健康算力平滑输出后续分析,确保核心业务生产不受任何硬件抖动影响。
让平台上的所有大模型服务,都持续满足预期的服务质量(如响应速度、生成流畅度、确定性低抖动)
按固定次数/固定上限一刀切配置硬阈值
固定阈值无法感知真实算力负载,旱涝不均。
大模型计算特征具备非线性的本质波动
简单日常问答与 32k+ 长代码分析的显存占用、KV Cache 与时长相差可达数十倍。
受批量并发 (Continuous Batching)、注意力矩阵填充度及节点网络负载等多重变量动态影响。
传统 APM 指标在 Transformer 架构下无法作为静态阈值依据。
感知微观硬件负载,毫秒级呼吸调整并发门限
弹性水位线动态吸顶,不浪费任何一颗 GPU 周期。
算力充裕时系统自动弹性放量,消除闲置气泡时间,让昂贵的高性能计算资源发挥极致产出。
高峰期或遇超长复杂任务时毫秒级退避防护,杜绝雪崩效应,稳固首字延迟 (TTFT) 及吐字速率。
告别平台工程师繁琐的人工压测与反复设参,多模型混部场景下自主适应吞吐基线并持续自我进化。
智能算力调度 · 告别资源闲置
解决传统模式下模型固定部署在指定算力上,导致低峰期算力空转浪费、高峰期算力不足的业务痛点。
模型低谷期大量算力闲置空转
算力随流量流动,集群 100% 满载
集群算力总池:固定 10 张 GPU 算力卡,实时无感流转
办公模型流量大
流量均衡
夜间任务流量大
算力随模型流量大小实时增减,两者资源占比之和始终保持 100%,彻底消除算力闲置
告别繁冗的人工基准盲测。ModelSphere 将线上真实请求、低谷空闲算力、网格化超参搜索与零停机灰度上线串联成全自动化演进飞轮。
用空闲算力持续榨干硬件潜能,让 LLM 推理服务越用越快。
静态数据集测试 → 7 天滑动窗口真实流量特征蓄水
占用生产资源压测 → 夜间低峰期闲置算力并发网格搜索
停机重启更新参数 → 冠军方案自动验证,生产环境零停机热加载
稳定运行,持续提供高质量低时延高可用服务
最优配置自动部署,零丢流热加载
构建滑动窗口数据集与前缀拓扑
基于真实负载比选出冠军推理方案
夜间低峰期并发搜索更优推理超参